——以简帛古文字AI科研为例
——以简帛古文字AI科研为例
2026年9月4日(周五)下午,故宫学研究院古文献研究所系列讲座第十八讲以线上腾讯会议方式举行。讲座由故宫博物院故宫学研究院、古文字与中华文明传承发展工程协同攻关创新平台共同主办,故宫学研究院古文献研究所承办,题目为“多智能体协作时代的古文字科研新方法:以简帛古文字AI科研为例”。湖南大学岳麓书院张天度博士主讲,故宫学研究院研究馆员、古文献研究所所长杨杨主持。
讲座伊始,张天度博士梳理了人工智能发展脉络。他指出,当今主流AI大模型本质是基于连接主义的人工智能,神经网络,经过数据训练,保存权重,“涌现”出新的能力。他以“大脑—家庭—公司组织”为喻:大模型相当于大脑,智能体为其配备工具,多智能体协作如组织分工;人工智能历经聊天大模型、智能体调用、多智能体协作三个时代,能力要求也从提示词撰写转向任务管理与分工协调。他强调,沟通与提出创新问题的能力愈发重要,古文字领域因数据非标准化程度高,大量工作,短期内难以被AI替代。
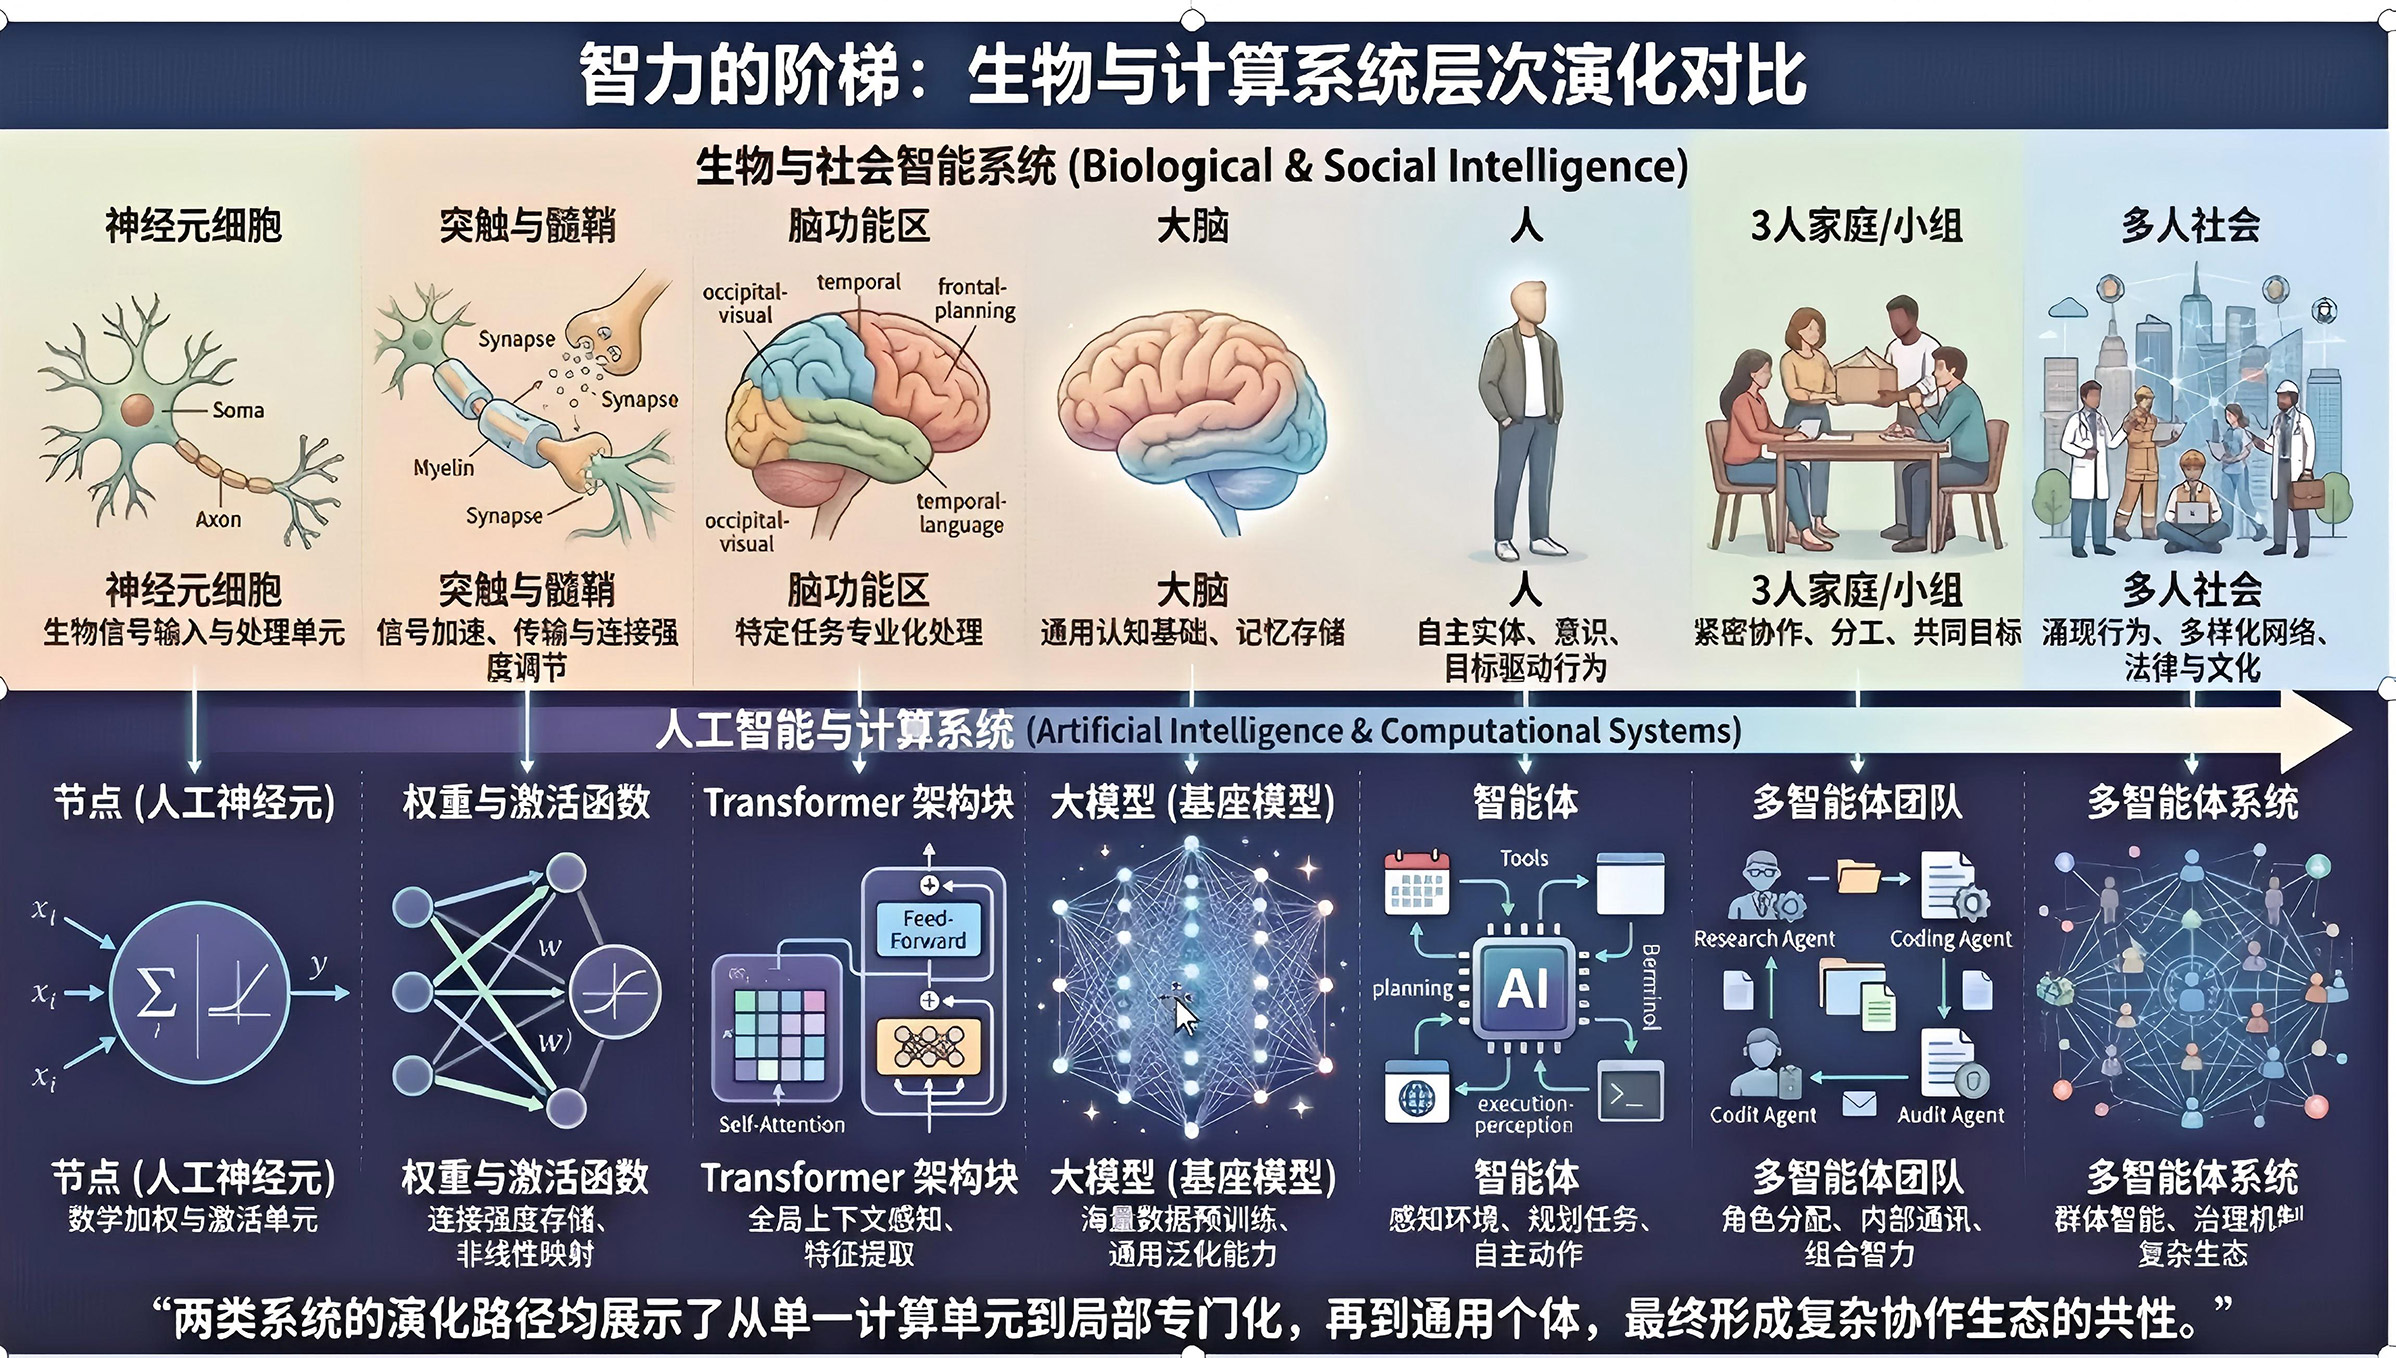
智力的阶梯:生物与计算系统层次演化对比(引自张天度博士讲座课件)
自然语言处理方面,他指出,通用文字有Unicode编码,古籍则因异体字、繁难字众多没有编码,处理困难。在文字层面,古文字材料可归纳为Unicode编码字、IDS构形字、隶定字图与原简图四种形态;以秦简为例,释读形成无标点文本后,依次经句读、分词与词性标注、命名实体抽取、词义消歧与通假判定,最终完成文白翻译。他还点评了基于BERT与“殆知阁”语料的“吾与点”、北大与字节跳动合作的“识典古籍”及AI太炎等平台,指出现有OCR可处理成书及PDF文献,但对简牍、甲骨等原始材料无能为力。
图像处理方面,他以岳麓秦简为例演示四环节:一是目标检测,确定各字在简面的位置并标框;二是图像分割与特征提取,借助墨迹检测模型将文字主体从竹纹等背景中提取;三是图像相似度检测,依据图像相似度匹配候选字;四是检索确认,由研究者判定最终释读。他强调,精细识别应遵循“检测—分割—识别—检索”路线并保留人工判断,而端到端直接输出释文并不可靠。
数据处理方面,他提出古文字数据自下而上分为图像、像素标注、编码、释读、学术标注与训练资产等层次,理想系统应自动记录人工操作。他认为错误率超10%的模型在科研中只能作为辅助工具,须警惕训练集与测试集信息泄露导致的识别率虚高,精良数据远比海量堆砌重要。
在实际操作方面,他强调提示词(prompt)依然重要,要素为角色定位、语境注入、思维链、负向限制与格式规范五个方面,并提醒每次调用都需要消耗词元(token)与成本。此外,演示了腾讯ima知识库、飞书多维表格批量整理学术论文,以及经MCP用自然语言驱动文档的操作,辨析MCP(外部工具接口)与Skill(封装经验的行为逻辑)之别,提醒慎用来源不明的“野生”技能。又以借助Kimi多智能体协作、从约一千字底稿完成论文为例,展示其拆分任务、统一注释体例、辅助制作PPT,建议先小范围试跑再扩规模,并指出历史类研究已可高度自动化,字形考释类论文则任重道远,仍有待数据完善。
新进展方面,他介绍死海古卷借助多光谱扫描与多模态大模型破译残损文本的研究,说明多模态模型兼识图、文、音视频的潜力。他分析古文字模型易“过拟合”、缺乏泛化能力的困境,点评了2024年以条件扩散模型推演甲骨字形的OBSD研究、微软以自监督学习和大规模数据开展的甲骨识别工作,以及发表于The Innovation、模拟专家考释流程的AlphaOracle系统,认为其首创性值得肯定,但受限于古文字预训练不足,仍需兼通两方面的复合型人才推进。
最后,他演示自研的简牍古文字AI处理系统:针对各类基础问题分别开发工具,聚合为小型古文字操作系统,支持材料输入、释文整理、字形处理、词典注释等任务。他建议尽快使用豆包Work工作模式,结合WorkBuddy、Trae SOLO及飞书多维表格搭建知识管理工作流,让通用大模型充当“管理者”,调度细分领域专用智能体,兼顾效率与深度。
张天度博士与杨杨研究馆员讲座合影
交流环节,听众就甲骨、青铜铭文识别条件、AI安全风险、与AI协作的学术成果认定、社教课程研发工具等问题,与主讲人进行了交流。本次讲座是系统而前沿的分享,展示了多智能体时代AI赋能古文字科研的方法、古文字学与人工智能交叉融合,启发学者更新科研范式、提升研究效率。
 图书馆
 视听馆
 故宫旗舰店
 全景故宫
 v故宫